Stan web crawlingu: wewnątrz bazy 66 milionów hostów
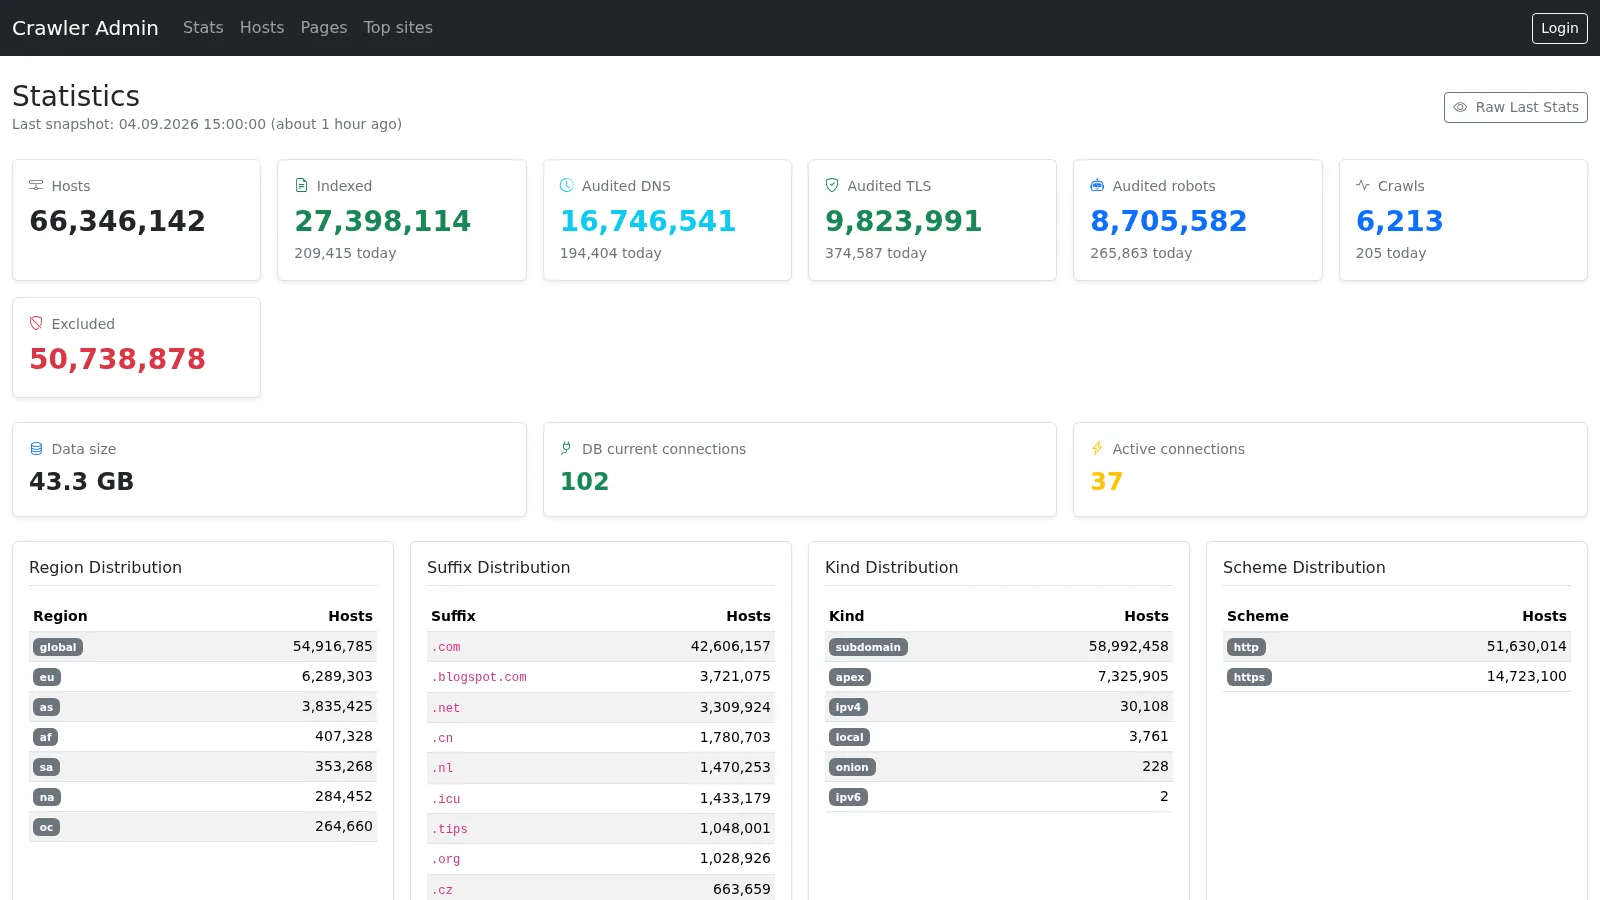
Nasz pulpit statystyk crawlera wykonuje zdjęcie bazy hostów co godzinę. Ten artykuł to stan crawlowania według ostatniego snapshotu w chwili pisania: 04.09.2026 15:00:00 (około godzinę temu). To spojrzenie od środka na bazę crawlera, która zbiera hosty od lat — na to, jak wygląda web, gdy spróbujesz go faktycznie policzyć.
Liczby jednym rzutem oka
| Metryka | Wartość |
|---|---|
| Hosty | 66 346 142 |
| Zindeksowane | 27 398 114 (209 415 dziś) |
| Audyty DNS | 16 746 541 (194 404 dziś) |
| Audyty TLS | 9 823 991 (374 587 dziś) |
| Audyty robots.txt | 8 705 582 (265 863 dziś) |
| Crawle | 6 213 (205 dziś) |
| Wykluczone | 50 738 878 |
| Rozmiar danych | 43,3 GB |
Około dwa z pięciu odkrytych hostów są zindeksowane (27,4 mln z 66,3 mln, 41%). Reszta czeka w kolejce przetwarzania albo została wykluczona z indeksowania — a grupa wykluczonych jest zdecydowanie największa, co dużo mówi o prawdziwym kształcie internetu.
Gdzie mieszkają hosty
| Region | Hosty |
|---|---|
| global | 54 916 785 |
| eu | 6 289 303 |
| as | 3 835 425 |
| af | 407 328 |
| sa | 353 268 |
| na | 284 452 |
| oc | 264 660 |
Większość hostów nie ma w ogóle sygnału regionalnego. Z 11,4 mln tych, które go mają, ponad połowa to Europa (6,3 mln), a Azja jest druga z wynikiem 3,8 mln. Afryka, Ameryka Południowa, Północna i Oceania mają po kilkaset tysięcy zidentyfikowanych hostów.
Rozkład sufiksów
| Sufiks | Hosty |
|---|---|
| .com | 42 606 157 |
| .blogspot.com | 3 721 075 |
| .net | 3 309 924 |
| .cn | 1 780 703 |
| .nl | 1 470 253 |
| .icu | 1 433 179 |
| .tips | 1 048 001 |
| .org | 1 028 926 |
| .cz | 663 659 |
| .de | 601 880 |
| .ir | 536 479 |
| .co.uk | 404 974 |
Sam .com obejmuje 64% wszystkich hostów. Na drugim miejscu nie jest TLD, tylko blogspot.com — miliony automatycznie wygenerowanych subdomen Bloggera. Wzorzec tanich TLD (.icu, .tips, .top) to klasyczny ślad rejestracji hurtowych, a .cn to największy kod kraju w tabeli.
Z czego składa się graf hostów
| Rodzaj | Hosty |
|---|---|
| subdomain | 58 992 458 |
| apex | 7 325 905 |
| ipv4 | 30 108 |
| local | 3 761 |
| onion | 228 |
| ipv6 | 2 |
| Schemat | Hosty |
|---|---|
| http | 51 630 014 |
| https | 14 723 100 |
Prawie 89% odkrytych hostów to subdomeny, a nie zarejestrowane domeny — graf rośnie głównie przez dodawanie etykiet, nie przez kupowanie nazw. Podział schematów jest ostrzejszy, niż większość ludzi oczekuje: tylko 22% odkrytych hostów znamy pod https. To surowy graf odkrywania, nie poddany audytowi web, i wciąż dominują w nim zwykłe linki http.
Zdrowie hostów
| Zdrowie | Hosty |
|---|---|
| excluded | 50 739 899 |
| reachable | 5 368 324 |
| alive | 3 112 402 |
| dead | 2 995 446 |
| discovered | 1 489 942 |
| unavailable | 1 372 536 |
| parked | 622 597 |
| degraded | 436 393 |
| misconfigured | 204 244 |
| invalid_url | 13 770 |
| unprocessable | 1 633 |
Z 15,6 mln hostów poza wykluczeniem 8,5 mln jest alive lub reachable — a 3,0 mln ma potwierdzony status dead, prawie jeden do trzech wobec grupy alive. Kolejne 1,5 mln czeka w discovered na pierwszy audyt. Web nieustannie się zmienia i to właśnie w tabeli zdrowia ta zmiana jest najlepiej widoczna.
Wykluczona połowa internetu
| Powód | Hosty |
|---|---|
| subdomain_trap | 48 755 256 |
| crawl_canonical_redirect | 748 767 |
| crawl_robots_txt_blocked | 531 616 |
| http_3xx_redirect | 401 111 |
| crawl_noindex | 197 307 |
| blocked | 78 943 |
| crawl_duplicate_content | 25 808 |
| no_follow | 70 |
Wykluczone 50,7 mln hostów to nie błąd zaokrąglenia — to większość bazy. Dominujący powód to subdomain_trap: hosty istniejące wyłącznie jako automatycznie generowane drabinki subdomen bez realnej treści. W naszych danych ta masa mocno ciąży ku stronom hostowanym w Chinach i tanim TLD — sam .cn ma 1,78 mln odkrytych hostów, a .icu, .top czy .com.cn dokładają kolejne setki tysięcy. Pozostałe wykluczenia to uczciwe sygnały: przekierowania kanoniczne, blokady robots.txt, przekierowania HTTP i noindex od właścicieli, którzy nie chcą być crawlowani.
Providerzy DNS
| Provider | Hosty |
|---|---|
| other | 4 913 304 |
| cloudflare | 2 312 051 |
| godaddy | 440 938 |
| aws | 373 727 |
| self-hosted | 332 451 |
| alibaba | 227 748 |
| ovh | 107 848 |
| 95 521 | |
| ionos | 86 668 |
| tencent | 82 777 |
Ta tabela liczy tylko hosty ze zidentyfikowanym providerem — 56,7 mln hostów nie ma w ogóle danych NS (missing lub none), co odzwierciedla masę wykluczeń. Wśród zidentyfikowanych Cloudflare jest największym nazwanym providerem z wyraczną przewagą, przed GoDaddy i AWS. Alibaba i Tencent razem obsługują ~310 tys. hostów — kolejne echo chińskiego udziału w grafie.
Co psuje się najczęściej: 10 kodów błędów audytów
| Kod | Hosty |
|---|---|
| dns_nxdomain | 4 067 545 |
| dns_noanswer | 682 526 |
| tcp_timeout | 248 623 |
| dns_servfail | 132 360 |
| tcp_unreachable | 124 130 |
| dns_timeout | 110 899 |
| http_h2_protocol_error | 82 267 |
| tls_handshake_failed | 51 561 |
| tcp_refused | 44 842 |
| dns_resolution_failed | 25 183 |
Baza rejestruje obecnie 5 671 631 błędów audytów, a 10 najczęstszych kodów pokrywa 98% z nich. Historia jest jednoznaczna: 72% wszystkich błędów to dns_nxdomain — domeny, które po prostu już nie istnieją — a około dziewięć na dziesięć błędów ma związek z DNS. Problemy transportowe i TLS to odległe drugie miejsce. Większość masy błędów to nie zepsuta infrastruktura, tylko nagromadzony gruz internetu.
Werdykty robots.txt
| Werdykt | Hosty |
|---|---|
| allowed | 5 658 486 |
| absent | 2 182 424 |
| blocked | 544 105 |
| unreachable | 320 567 |
Z 8,7 mln hostów z zakończonym audytem robots.txt 65% jawnie zezwala na crawlowanie, a kolejne 25% nie ma robots.txt wcale, co domyślnie oznacza zgodę. Tylko 544 tys. hostów aktywnie blokuje crawlery — przypomnienie, że zdecydowana większość internetu jest, zgodnie z własną deklaracją, otwarta na indeksowanie.
Szerszy kontekst
Godzinowe trendy za snapshotem pokazują stabilny, liniowy wzrost: około 11 tys. nowych hostów i 13 tys. nowo zindeksowanych stron co godzinę, dzień po dniu. Nic nie eksploduje i nic się nie zawala — to dojrzały crawl w równowadze między odkrywaniem, audytem i wykluczaniem.
Pełny pulpit wraz z tabelą trendów godzinowych jest publicznie dostępny na crawler.pceuropa.net/stats i odświeża się co godzinę. Jeśli interesuje Cię ekonomia takiej operacji, zobacz dlaczego rekomendujemy Preemptible/Spot VMs do crawlingu.